Futurion Solutions
· Ivan Skachkov · Infraestructura de IA · 10 min read
De una pregunta de un cliente a $0,80 por minuto de vídeo generado con IA.
Cómo una pregunta de un cliente llevó a una prueba de concepto de generación de vídeo con IA y a una comparación de costes de GPU.
Empezó en una reunión habitual con un cliente.
Habíamos programado una de nuestras llamadas de descubrimiento. El cliente buscaba formas de mejorar sus procesos de gobernanza, riesgos y cumplimiento con nuestro servicio de automatización GRC.
Nada fuera de lo normal para nosotros. Es exactamente el tipo de conversación que tenemos con empresas que intentan reducir el trabajo manual, mejorar sus procesos internos y entender qué se puede automatizar de forma realista.
Pero, en algún momento de la conversación, nos desviamos por completo del tema.
El cliente empezó a hablar de su proceso de producción de marketing.
Estaban produciendo vídeos con IA, incluido el doblaje de contenidos a distintos idiomas.
Nada que ver con GRC.
Entonces llegó una pregunta que no esperaba:
«Por cierto, si trabajáis con IA local, ¿podéis hacer que esto funcione en local para nosotros?»
Interesante pregunta.
Trabajamos con modelos locales. Gemma, MedGemma, Qwen, Mistral: estas son algunas de las familias de modelos con las que trabajamos, sobre todo para tareas relacionadas con texto.
Pero ¿producción y doblaje de vídeo?
Nunca habíamos explorado esa área en serio.
Si podemos ejecutar modelos de lenguaje en local, ¿por qué no íbamos a poder hacer algo parecido con vídeo y audio?
¿Qué haría falta?
¿Qué funcionaría realmente?
¿Y qué parte del proceso de producción actual podría permanecer bajo el control del propio cliente, en lugar de depender por completo de un servicio comercial de generación de vídeo?
Para ser sincero, aquella noche no pude dormir.
A la mañana siguiente, empezamos a buscar respuestas
A la mañana siguiente, mi equipo y yo empezamos a investigar qué había disponible realmente.
Al principio, la tarea parecía relativamente sencilla.
Encontrar un modelo de generación de vídeo con pesos abiertos, desplegarlo en local y comprobar si podíamos producir algo comparable a los servicios comerciales que el cliente ya utilizaba.
Pero los personajes tenían que seguir siendo reconocibles en distintas escenas. La voz y el sonido eran partes importantes del proceso de producción.
Calidad de vídeo: 720p
24 fotogramas por segundo
Generar vídeos con imágenes de referencia
vídeo existente
Usar audio
Eso redujo considerablemente nuestra lista.
Estudiamos Wan 2.2, LTX-2.3, LTX-2.5, HunyuanVideo y MiniMax H3.
Pero no buscábamos un modelo que simplemente pudiera animar una imagen.
Necesitábamos algo capaz de trabajar con varios tipos de referencias, producir audio sincronizado y mantener una coherencia razonable entre los personajes.
Durante la investigación, MiniMax H3 —y, en particular, MiniMax H3 Ref2VA— llamó nuestra atención.
¡Dos horas y media para generar cinco segundos de vídeo!
Nuestro entorno inicial era un Apple M2 Pro con 32 GB.
Queríamos entender qué era posible con el hardware que ya teníamos antes de pasar a algo más caro.
Y funcionó.
Generamos un vídeo de 5,17 segundos.
704 × 1280
Resolución
24 fps
Frecuencia
Estéreo
audio incluido
2 horas, 30 minutos y 16 segundos.
Solo ocho pasos de eliminación de ruido consumieron unos 142 minutos. La decodificación del vídeo añadió otros 7,7 minutos. El uso máximo de memoria de la GPU alcanzó los 20,06 GB.
Así que sí, el proceso funcionó.
Pero estaba claro que no era algo que pudiéramos recomendar para el proceso de producción de vídeo con IA de un cliente.
El problema inmediato no era el modelo.
Era el hardware.
Necesitábamos potencia de GPU
¿Qué GPU haría que esto fuera viable?
Empezamos a estudiar configuraciones V100, V100S, L4, A100 y RTX PRO Blackwell.
VRAM, rendimiento de inferencia, cuantización, descarga parcial del modelo: de repente, todo esto pasó a formar parte de la conversación.
Para esta carga de trabajo concreta, nuestra investigación apuntaba a GPU con al menos 32 GB de VRAM como punto de partida más práctico.
Entonces surgió otra pregunta.
¿Dónde debíamos ejecutarlas?
Estudiamos proveedores como Hetzner y OVH, pero el precio de los servidores dedicados no tenía mucho sentido para un experimento.
No necesitábamos un servidor con GPU funcionando las 24 horas del día.
Queríamos iniciar uno, probar el modelo, apagarlo y pagar por lo que realmente usáramos.
Así llegamos a RunPod.
El alquiler de GPU por horas era interesante. El almacenamiento persistente también resultaba útil.
Pero hubo algo más que llamó mi atención…
ComfyUI es como n8n, pero para modelos
A estas alturas, ya teníamos el proceso de generación de vídeo funcionando en Mac.
No necesitábamos ComfyUI para demostrar que el modelo podía ejecutarse.
Lo que me gustó fue la interfaz.
Si habéis trabajado con n8n, reconoceréis el concepto básico.
En n8n, conectáis nodos para automatizar procesos entre aplicaciones y servicios.
ComfyUI utiliza un enfoque visual similar, pero para modelos generativos.
Conectáis nodos para cargar modelos, añadir referencias de imagen, vídeo y audio, configurar los parámetros de generación y producir el resultado final.
Podéis ver todo el proceso delante de vosotros.
Podéis cambiar pasos individuales sin modificar scripts constantemente.
Para mí, eso era mucho más cómodo que hacerlo todo a través de GitHub.
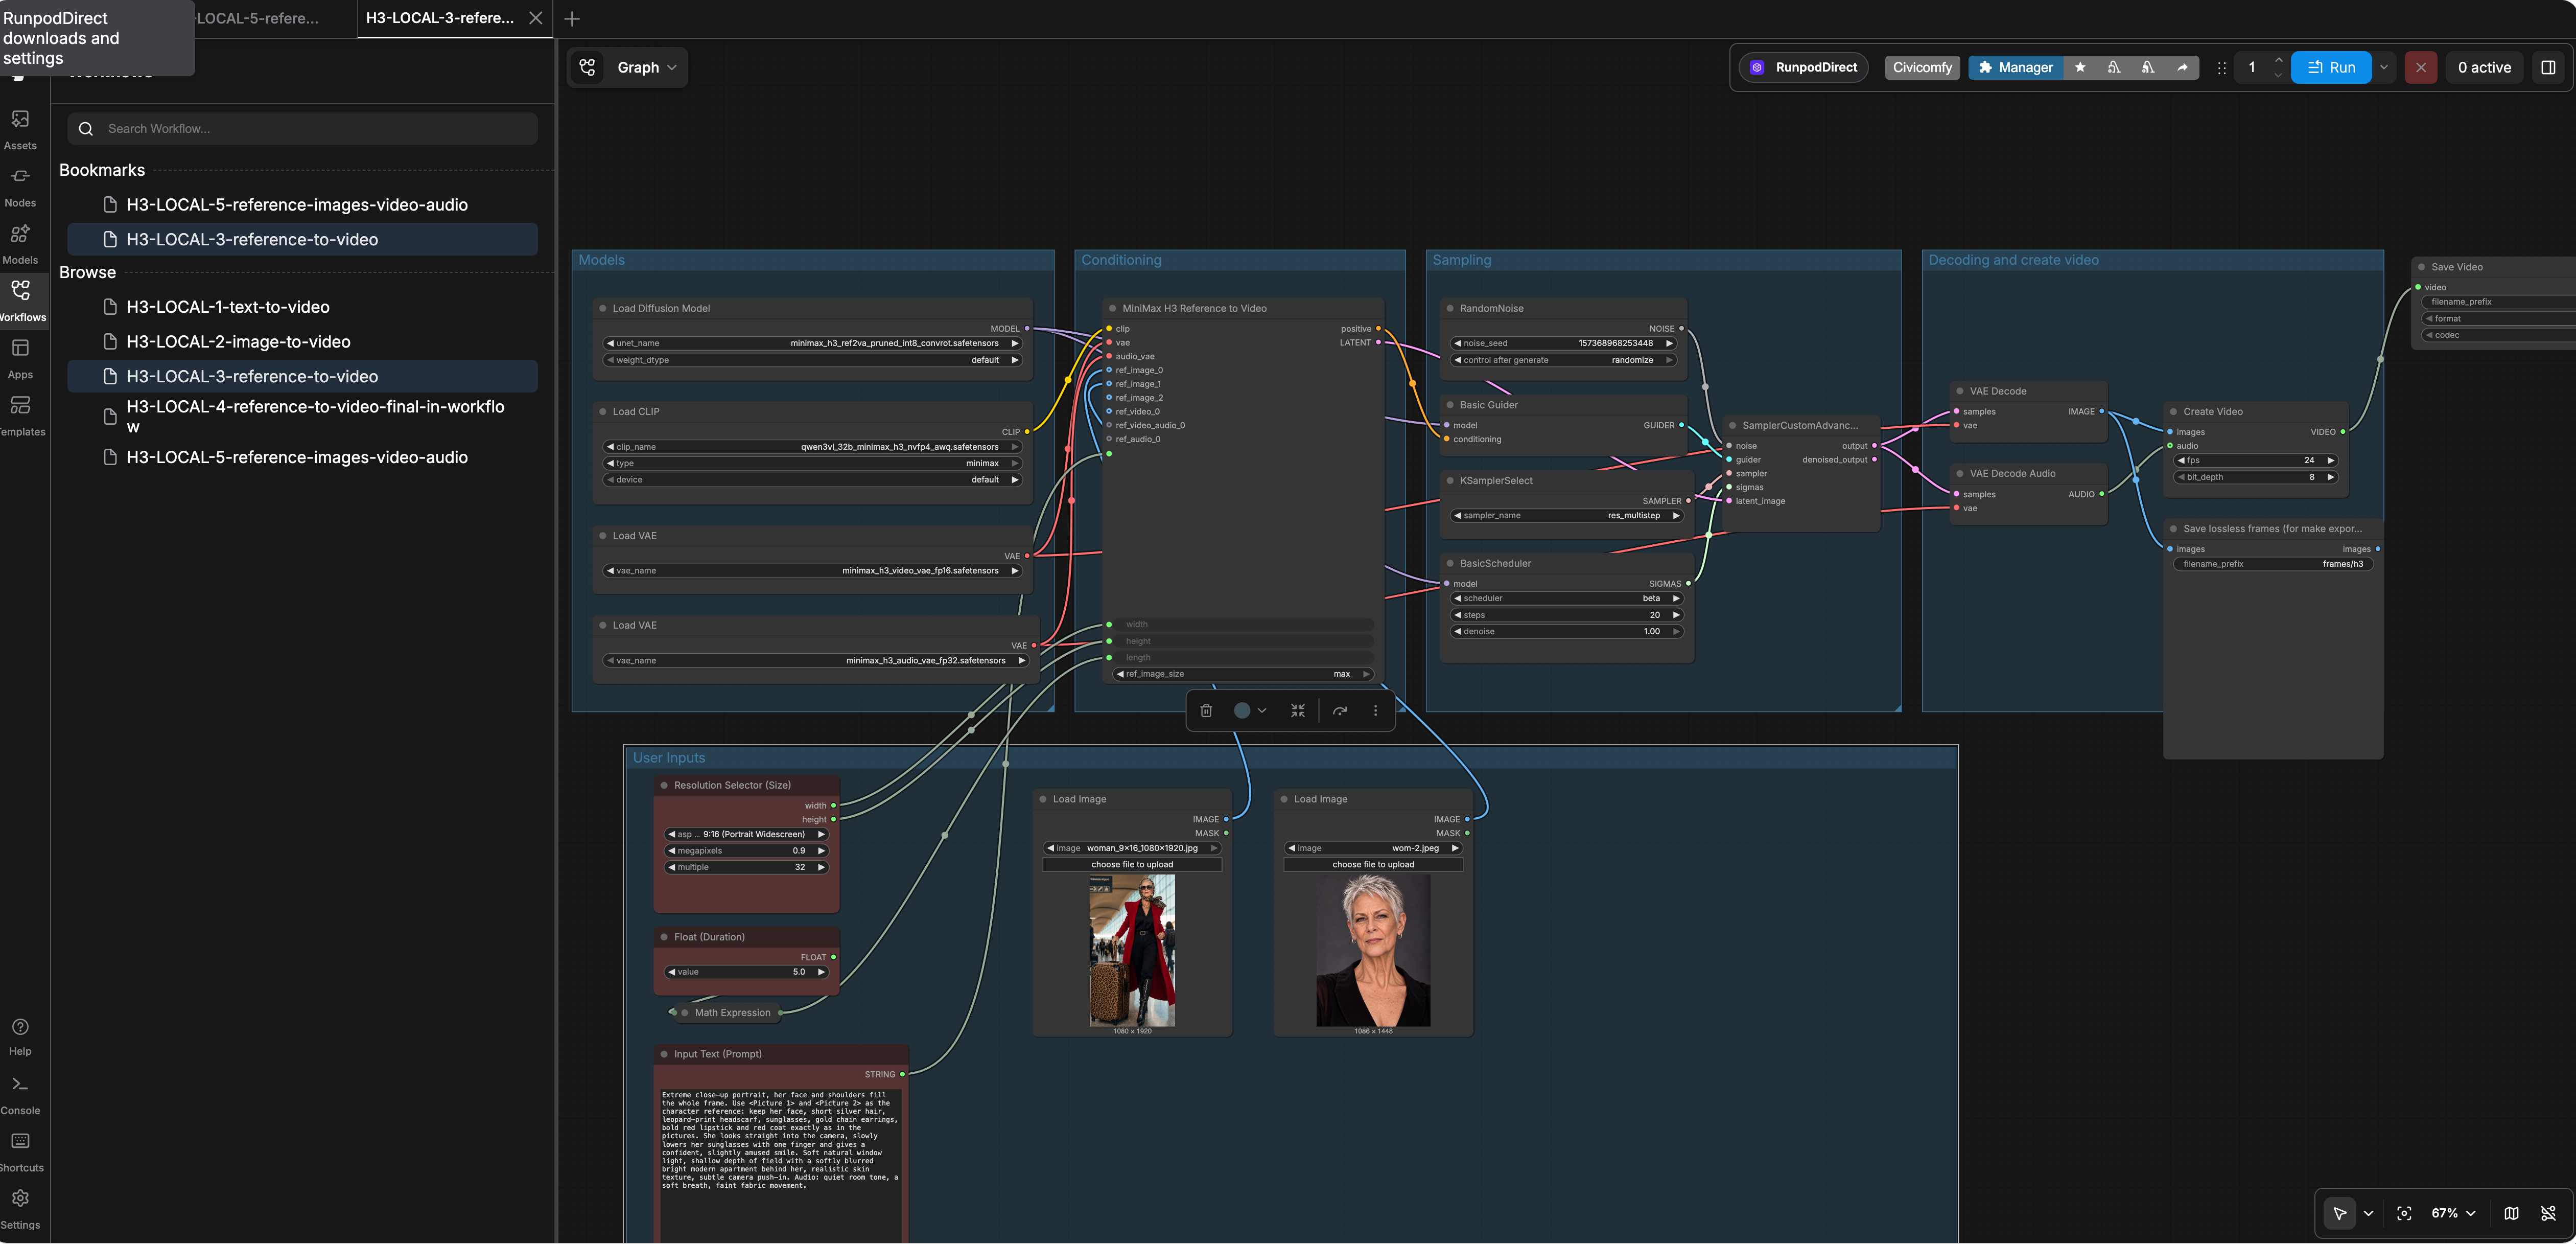
Así que, para la prueba de concepto, la dirección quedó clara:
No todas las RTX 5090 rinden como una RTX 5090
Entonces las cosas se pusieron más interesantes.
Empezamos a experimentar con RunPod Community Cloud.
La idea sonaba bien: alquilar una RTX 5090 al precio de Community, generar los vídeos y detener la GPU al terminar.
Pero observamos algo inesperado.
Algunos servidores con RTX 5090 tenían un límite de potencia de GPU de solo 400 W.
Y la diferencia de rendimiento era enorme.
En un servidor Community medimos:
86,9 segundos por paso de muestreo.
En un servidor Secure Cloud:
15,6 segundos.
Más de cinco veces más rápido.
Al principio parecía que Community Cloud podía ser simplemente demasiado impredecible.
Entonces encontramos otra RTX 5090 de Community con un límite de potencia de 536 W.
Su resultado:
15,1 segundos por paso de muestreo.
Casi idéntico a Secure Cloud.
Así que el problema no era simplemente:
Community Cloud malo. Secure Cloud bueno.
El verdadero problema era:
¿Cómo encontramos una buena GPU antes de dedicar tiempo y dinero a descargar modelos e intentar una generación?
Encontrar una GPU
Normalmente, iniciáis la GPU, os conectáis a ella, descargáis los modelos y empezáis a generar.
Pero si la máquina resulta ser lenta o poco fiable, ya habéis perdido tiempo.
Nuestro conjunto de modelos reducido ocupaba aproximadamente 72 GB.
Descargar 72 GB antes de descubrir que la GPU no sirve no es una buena forma de trabajar.
Así que añadimos la búsqueda de GPU a nuestro script de despliegue.
La lógica es relativamente sencilla.
Nuestro script puede:
- Solicitar un pod de RTX 5090 en Community Cloud con 120 GB de espacio en disco.
- Esperar a SSH y verificar la disponibilidad de CUDA mediante PyTorch o ComfyUI.
- Comprobar el límite de potencia de la GPU.
- Tomar muestras de la utilización de la GPU en reposo.
- Rechazar servidores que indiquen menos de 500 W o superen un 20 % de utilización media de GPU antes de iniciar nuestra carga de trabajo.
- Detener el pod rechazado, esperar dos minutos y volver a intentarlo.
Una GPU más barata por hora no produce necesariamente vídeo más barato
Una vez que el proceso fue lo bastante estable para probarlo repetidamente, empezamos a medir el tiempo de generación y el coste de la infraestructura.
Para mantener la coherencia, utilizamos una carga de trabajo de cinco segundos con 20 pasos de muestreo a una resolución de 736 × 1312.
Comparamos tres configuraciones.
| Configuración de GPU | Tiempo de generación por clip de 5 segundos | Coste por minuto de vídeo generado |
|---|---|---|
| Community — modelos reducidos, servidor rápido | 5,7 min | $0,80 |
| Secure — modelos reducidos | 6,7 min | $1,61 |
| Secure — modelos completos | 8,2 min | $2,05 |
El resultado fue interesante.
Cuando encontramos un servidor Community rápido, el coste estimado de infraestructura fue aproximadamente la mitad del coste de Secure Cloud.
Pero en máquinas Community más lentas, el coste proyectado aumentó hasta aproximadamente $3,20–$4,90 por minuto de vídeo generado.
Lo que lleva a una conclusión bastante sencilla:
Si la generación tarda más, pagáis por ese tiempo adicional de ejecución.
En nuestras mediciones, Community Cloud solo seguía siendo más barato que Secure Cloud cuando el servidor completaba un paso de muestreo en aproximadamente 31 segundos o menos.
Por eso mismo resultó útil nuestro script de búsqueda de GPU.
Estas cifras incluyen los costes estimados de almacenamiento, pero excluyen el tiempo de arranque, los recursos inactivos, las generaciones fallidas, la edición y otros costes de producción.
¿Y qué pasa con el tiempo de arranque?
El coste no era lo único que importaba.
También queríamos entender qué ocurre cuando alguien realmente quiere empezar a trabajar.
Con un pod nuevo de Community Cloud y el conjunto de modelos reducido, nuestras mediciones fueron aproximadamente:
- 10 minutos para descargar unos 72 GB de modelos.
- 5,7 minutos para generar el primer clip de cinco segundos en una RTX 5090 rápida.
Así que unos 16 minutos desde que se encuentra la GPU hasta que se recibe el primer resultado.
Pero eso no incluye la búsqueda de GPU.
Si la disponibilidad de RTX 5090 es limitada o varios servidores no superan nuestras comprobaciones, el cliente puede esperar bastante más.
Secure Cloud se comportó de otra manera.
Se estimó que un despliegue limpio con los modelos reducidos necesitaba unos 3,5 minutos de preparación, seguidos de aproximadamente 6,7 minutos de generación.
Unos 10 minutos hasta el primer vídeo de cinco segundos.
Y cuando los modelos ya estaban guardados en un volumen persistente, un reinicio con los modelos disponibles alcanzó la fase de verificación en solo 65 segundos.
La diferencia no era solo el coste.
Era la previsibilidad.
¿Secure Cloud o Community Cloud?
En este punto, teníamos dos opciones prácticas de despliegue.
Secure Cloud
Iniciar un entorno más previsible, obtener un rendimiento y una disponibilidad más constantes y pagar un precio por hora más alto.
Tiene sentido cuando alguien genera vídeos con regularidad y no quiere esperar a una GPU Community adecuada.
Community Cloud
Ejecutar nuestro script de búsqueda y dejar que busque una RTX 5090 aceptable.
Una vez encontrada, preparar el entorno y empezar a generar.
Cuando el script encuentra un servidor rápido, el coste de infraestructura puede ser aproximadamente la mitad del coste de Secure Cloud.
La contrapartida es un tiempo de arranque potencialmente más largo y una disponibilidad menos previsible.
No hay razón para fingir que una opción es universalmente mejor.
Dejemos que el cliente decida si le importa más el coste o la previsibilidad.
Y hay otra distinción importante.
Ambas opciones siguen utilizando infraestructura de GPU alquilada.
Ofrecen más control sobre el entorno de ejecución y los modelos que utilizamos, pero no son lo mismo que ejecutar todo en hardware físico dentro de la propia infraestructura del cliente.
¿Tiene sentido económico todo esto?
Ya existen servicios comerciales de vídeo.
Os suscribís, subís vuestras referencias, generáis el vídeo y pagáis los créditos.
¿Por qué complicarse con modelos, GPU, scripts, almacenamiento y despliegue?
Utilizamos Seedance 2.0 Fast como referencia, por ser el modelo base de nuestro cliente.
Con nuestra tasa de consumo estimada de 24 créditos por segundo, un minuto de vídeo generado requiere 1.440 créditos.
El coste efectivo depende del plan de suscripción.
Para nuestro propio proceso, utilizamos los tiempos de generación y los costes de infraestructura de nuestros experimentos en RunPod.
| Solución | Coste por minuto de vídeo generado |
|---|---|
| Seedance 2.0 Fast — Standard | $34,56 |
| Seedance 2.0 Fast — Pro | $22,40 |
| Seedance 2.0 Fast — Max | $14,40 |
| Seedance 2.0 Fast — Team | $7,20 |
| RunPod Community — modelos reducidos | $0,80 |
| RunPod Secure — modelos reducidos | $1,61 |
| RunPod Secure — modelos completos | $2,05 |
La diferencia es considerable.
Incluso frente a la opción más barata de Seedance, el plan Team, nuestra configuración de Secure Cloud con modelos completos resultó aproximadamente un 72 % más barata.
Y la configuración Community alcanzó aproximadamente $0,80 por minuto generado.
Es unas nueve veces más barata que la cifra de Seedance Team en nuestra comparación.
Lo que empezó como una conversación sobre GRC
Empezamos con GRC y terminamos construyendo un proceso de generación de vídeo.
No era exactamente lo que habíamos planeado.
Pero eso es lo que me gusta de trabajar directamente con clientes. A veces, los proyectos más interesantes empiezan con una pregunta que no tiene nada que ver con la reunión original.
Tuvimos que investigar, experimentar, fallar unas cuantas veces y encontrar soluciones.
Ahora tenemos una prueba de concepto que funciona, mediciones reales de rendimiento y una comprensión mucho mejor de los costes.
¿Merece la pena explorarlo?
A la vista de nuestros resultados, sin duda.
Así que aquí va mi pregunta para vosotros.
¿Hay algo en vuestra empresa que creáis que podría automatizarse o mejorarse?
¿Algo que nunca os hayáis planteado ejecutar en vuestra propia infraestructura?
Contádnoslo.
Quizá vuestra pregunta se convierta en nuestro próximo experimento.